Всего несколько месяцев назад многие люди сочли бы невообразимым, насколько хорошо «языковые модели» на основе искусственного интеллекта могут имитировать человеческую речь. То, что пишет ChatGPT, часто неотличимо от текста, созданного человеком.
Исследовательская группа из Института немецкого языка Лейбница (IDS) в Мангейме (Германия) в настоящее время использовала текстовые материалы на 1293 различных языках , чтобы выяснить, насколько быстро различные модели компьютерного языка учатся «писать». Неожиданный результат: языки, на которых говорит большое количество людей, обычно сложнее изучать алгоритмам, чем языки с меньшим лингвистическим сообществом. Исследование опубликовано в журнале Scientific Reports.
Языковые модели — это компьютерные алгоритмы , которые могут обрабатывать и генерировать человеческий язык. Языковая модель может распознавать закономерности и закономерности в больших объемах текстовых данных и, таким образом, постепенно учится предсказывать будущий текст. Одной из конкретных языковых моделей является так называемая модель «Трансформер», на которой был построен известный сервис чат-ботов ChatGPT.
Поскольку алгоритм получает сгенерированный человеком текст, он развивает понимание вероятностей, с которыми компоненты слов, слова и фразы встречаются в определенных контекстах. Эти полученные знания затем используются для прогнозирования, то есть для создания новых текстов в новых ситуациях.
Например, когда модель анализирует предложение «Темной ночью я услышал далекий…», она может предсказать, что подходящим продолжением будут такие слова, как «вой» или «шум». Это предсказание основано на некотором «понимании» семантических связей и вероятностей словосочетаний в языке.
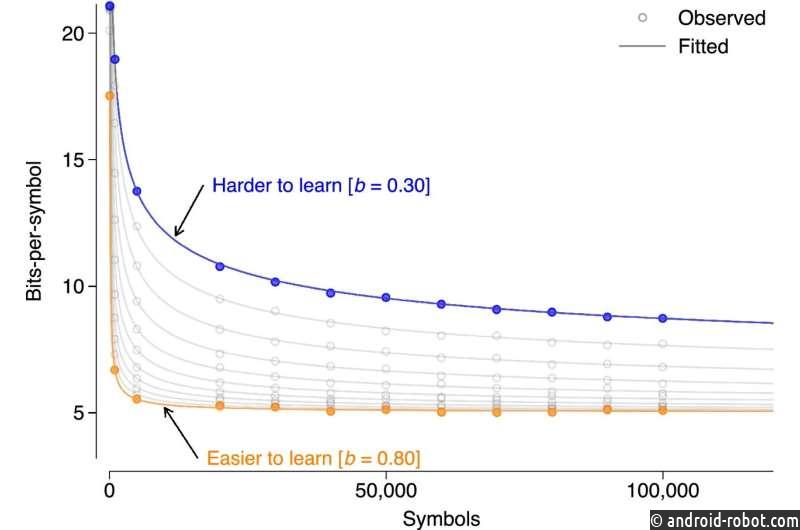
В новом исследовании группа лингвистов IDS изучила, насколько быстро компьютерные языковые модели учатся прогнозировать, обучая их текстовому материалу на 1293 языках. Команда использовала старые и менее сложные языковые модели, а также современные варианты, такие как упомянутая выше модель Transformer. Они посмотрели, сколько времени потребовалось различным алгоритмам, чтобы понять закономерности на разных языках.
Исследование показало, что объем текста, который алгоритм должен обработать для изучения языка, то есть для прогнозирования того, что последует за этим, варьируется от языка к языку. Оказывается, языковым алгоритмам, как правило, труднее изучать языки, на которых много носителей, чем языки, на которых говорит меньшее количество носителей.
Однако это не так просто, как кажется. Чтобы подтвердить взаимосвязь между трудностями обучения и численностью говорящих, важно учитывать несколько факторов.
Проблема заключается в том, что близкородственные языки (например, немецкий и шведский) гораздо более похожи, чем языки, находящиеся в отдаленном родстве (например, немецкий и тайский). Однако необходимо контролировать не только степень родства между языками, но и другие эффекты, такие как географическая близость двух языков или качество текстового материала, используемого для обучения.
«В нашем исследовании мы использовали различные методы, от прикладной статистики до машинного обучения, чтобы максимально тщательно контролировать потенциальные мешающие факторы», — объясняет Саша Вулфер, один из двух авторов исследования.
Однако независимо от метода и типа используемого входного текста была обнаружена устойчивая статистическая корреляция между машинным обучением и численностью говорящих.
«Результат нас действительно удивил; исходя из текущего состояния исследований, мы ожидали обратного: что языки с большим количеством носителей, как правило, легче изучать машине», — говорит Александр Коплениг, ведущий автор исследования.
О причинах такой связи пока можно только предполагать. Например, более раннее исследование, проведенное той же исследовательской группой, показало, что более крупные языки в целом имеют тенденцию быть более сложными. Так что, возможно, увеличение усилий по обучению «окупается» для изучающих человеческий язык: потому что, как только вы выучите сложный язык, вам станут доступны более разнообразные лингвистические возможности, которые могут позволить вам выразить одно и то же содержание в более короткой форме.
Но необходимы дополнительные исследования, чтобы проверить эти (или другие объяснения). «Мы все еще находимся в начале пути», — отмечает Коплениг. «Следующий шаг — выяснить, можно ли и в какой степени результаты нашего машинного обучения перенести на овладение человеческим языком».